你有没有想过,你敲下的那几行 .c 代码,是怎么从一个普通的文本文件,"长大"成一个双击就能跑的软件?
它像一个小孩子一样,要经过好几道成长仪式——每一步都在悄悄修剪、翻译、组装,最后才变成电脑听得懂的机器语言。今天,我们就牵着它的小手,陪它走完这一程。
两个世界:翻译环境与运行环境
在 ANSI C 的世界里,一个程序的诞生分成两个大环境:
翻译环境:把源程序「翻译」成机器能执行的二进制指令。就像把一本外文书翻译成中文。
运行环境:真正去「执行」已经翻译好的程序。就像认真读完这本翻译好的书。
编译的四个小站
翻译环境又分成两大步:编译和链接。其中「编译」还能再拆成三个小动作:预处理、编译、汇编。
第一站 · 预处理
这一站专门处理那些以 # 开头的指令,比如 #include、#define。它会把 .c 变成 .i 文件。用 gcc 可以单独走到这一站:
gcc -E test.c -o test.i它主要做这几件事:删除所有 #define 并完成宏替换、处理条件编译、把头文件内容递归塞进来、删掉注释、加行号标识,还会保留 #pragma 指令给后面用。
第二站 · 编译
这一站把 .i 变成汇编代码 .s。它会认真地对代码做词法分析、语法分析、语义分析,像一位细心的语文老师:
array[index] = (index + 4) * (2 + 6);- 词法分析:把字符切成一个个记号(关键字、标识符、字面量……)。
- 语法分析:把这些记号拼成一棵「语法树」。
- 语义分析:检查声明和类型是否匹配、有没有不合理的转换。
gcc -S test.i -o test.s第三站 · 汇编
汇编器把汇编代码逐句翻译成机器指令(二进制),变成目标文件 .o,几乎一句汇编对应一条机器指令,不做额外优化。
gcc -c test.s -o test.o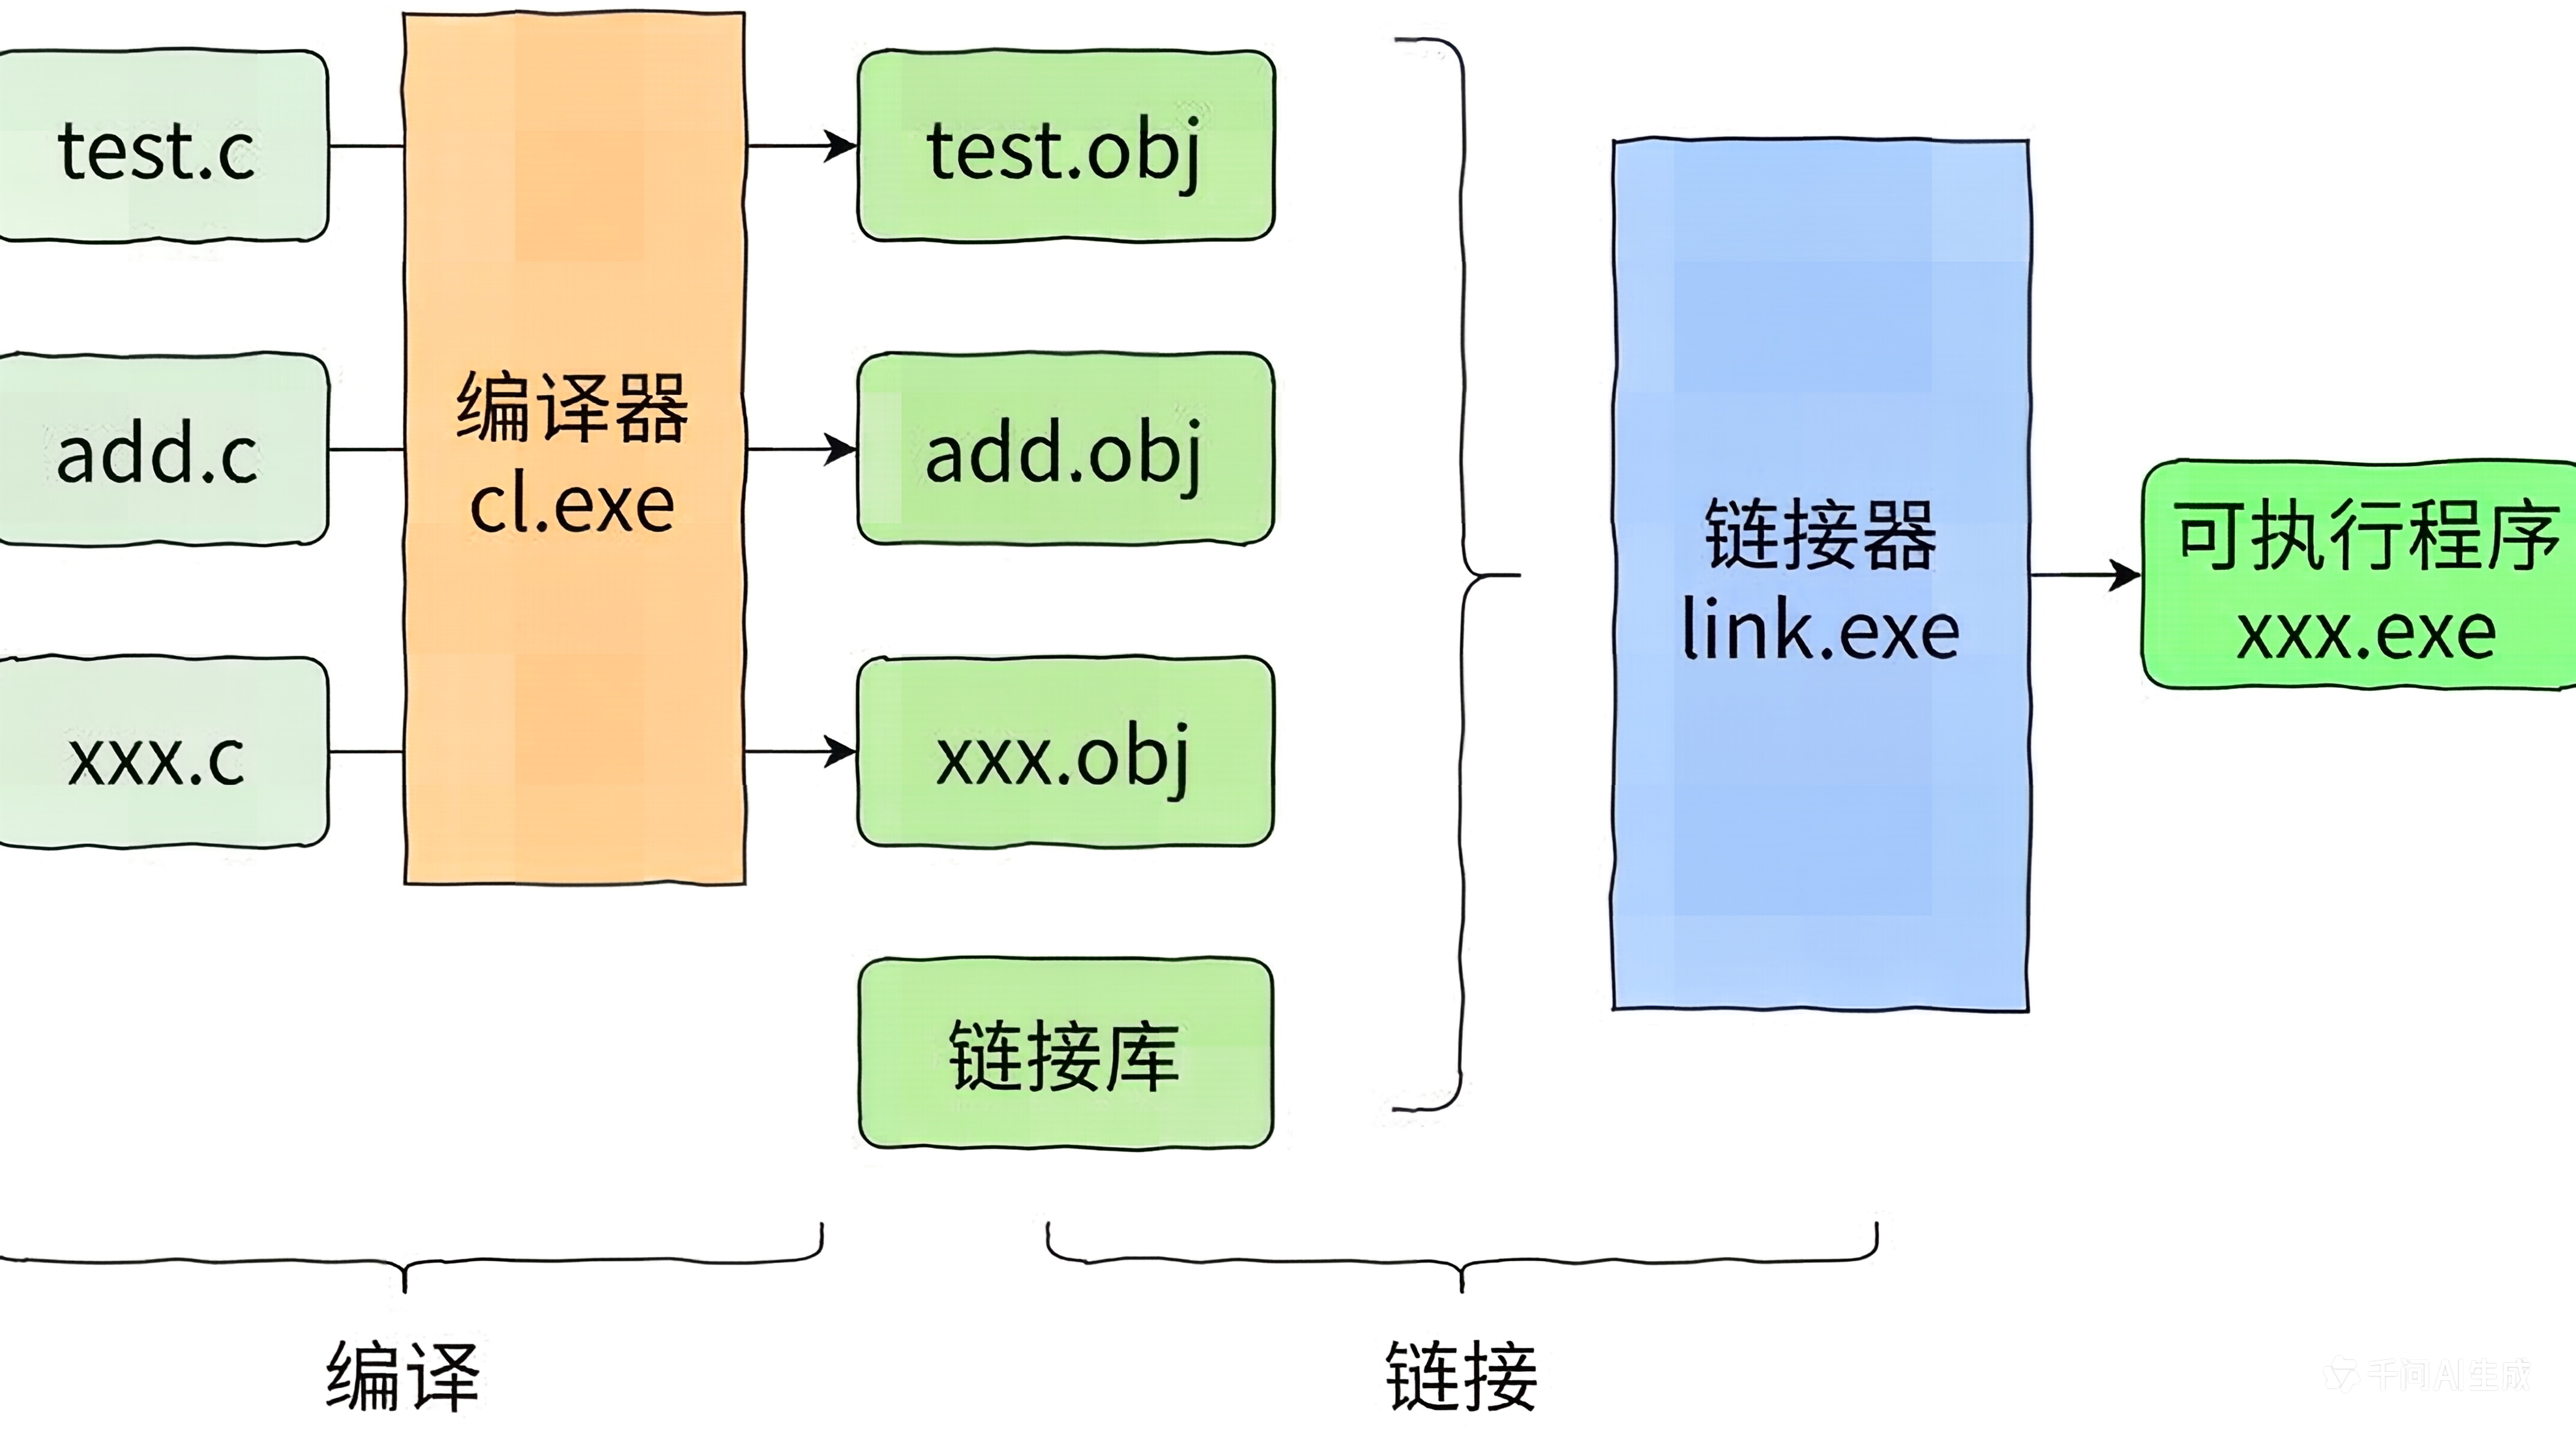
最关键的一站 · 链接
编译完后,一堆 .o 文件各自为政,谁也不知道别的模块里的函数在哪儿。链接器要做的,就是地址分配、符号决议和重定位,把它们拼成一个可执行程序。
举个栗子,一个项目里有 test.c 和 add.c:
// test.c 里用到了 add.c 的 Add 函数和全局变量 g_val
// 但编译 test.c 时,编译器根本不知道 Add 和 g_val 的真实地址
于是它先把这些「待定地址」空着,等链接时,再由链接器去别的模块里找到 Add 的真实地址,把之前所有引用它的指令地址都改回来——这个过程就叫重定位。全局变量 g_val 也是同样的道理。
运行环境:真正上场了
链接完成、可执行程序诞生后,就轮到运行环境登场:
操作系统把程序加载进内存 → 调用 main 开始执行 → 程序用到一个运行时栈(stack)存放局部变量和返回地址,也可以使用静态内存 → main 结束,程序返回一个退出码(通常 0 表示成功,非 0 表示失败)。
✿ 摘要
- 程序要经历翻译环境与运行环境。
- 翻译 = 编译(预处理 → 编译 → 汇编)+ 链接。
- 预处理处理
#指令;编译做词法/语法/语义分析;汇编转机器码。 - 链接负责地址分配、符号决议、重定位,把多文件拼成可执行程序。
- 运行环境加载并执行
main,返回退出码。
愿当下的花如你所见般美丽
评论交流
欢迎留下你的想法