花园里最后一朵主花,留给排序。把一串乱糟糟的数字排成整整齐齐的一列,是很有治愈感的事。先记一个小概念:稳定性——排序后,值相同的记录如果还保持原来的先后顺序,这个算法就是稳定的。今天把八位排序小将挨个请出来。
开工前先备好一把人人都要用的小钥匙——交换:
void Swap(int* pa, int* pb)
{
    int tmp = *pa;
    *pa = *pb;
    *pb = tmp;
}
直接插入排序:像整理手牌
打扑克时理牌的动作就是它:摸一张新牌,在已经有序的手牌里从后往前找位置,大的往后挪,把它轻轻插进去。
void InsertSort(int* a, int n)
{
    for (int i = 0; i < n - 1; i++)
    {
        int end = i;
        int tmp = a[end + 1];     // 新摸到的那张牌
        while (end >= 0)
        {
            if (a[end] > tmp)
            {
                a[end + 1] = a[end];  // 比它大的往后挪
                end--;
            }
            else
                break;
        }
        a[end + 1] = tmp;         // 落座
    }
}
希尔排序:先大步走,再小步挪
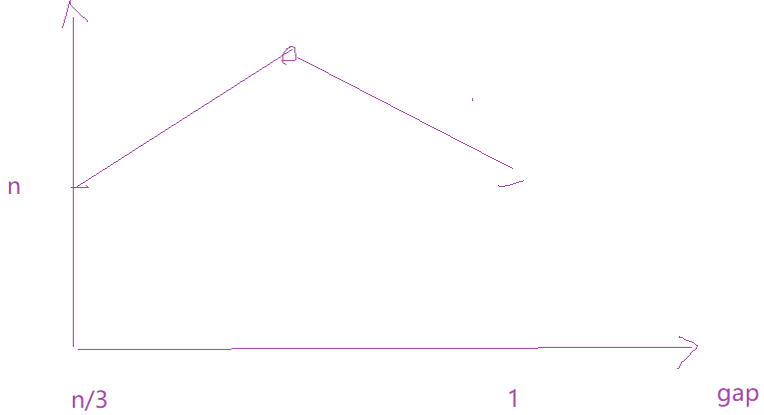
希尔给插入排序做了个可爱升级:先按间隔 gap 分组做预排序,让大数快点跳到后面、小数快点跳到前面;gap 逐渐缩小到 1,就退化成普通插入排序——但那时数组已经几乎有序,插起来飞快。
void ShellSort(int* a, int n)
{
    int gap = n;
    while (gap > 1)
    {
        gap = gap / 3 + 1;   // +1 保证最后一次一定是1
        // gap > 1 是预排序,gap == 1 就是插入排序
        for (int i = 0; i < n - gap; i++)
        {
            int end = i;
            int tmp = a[end + gap];
            while (end >= 0)
            {
                if (tmp < a[end])
                {
                    a[end + gap] = a[end];
                    end -= gap;
                }
                else
                    break;
            }
            a[end + gap] = tmp;
        }
    }
}
时间复杂度约 O(N^1.3),比 O(N²) 优雅了好多。
分组的方式不止一种,源码里还有「一组一组来」的写法——先把第一组排好,再排第二组:
// 第一种写法:一组一组来
void ShellSort(int* a, int n)
{
    int gap = 3;
    for (int j = 0; j < gap; j++)       // 一共 gap 组
    {
        for (int i = j; i < n - gap; i += gap)
        {
            int end = i;
            int tmp = a[end + gap];
            while (end >= 0)
            {
                if (tmp < a[end])
                {
                    a[end + gap] = a[end];
                    end -= gap;
                }
                else
                    break;
            }
            a[end + gap] = tmp;
        }
    }
}
还有「多组并着走」的写法,其实和上面那个合并写法是同一件事——多组交叉着同时推进。至于时间复杂度为什么是 O(N^1.3),源码里给了一段能「征服面试官」的推导:
假设忽略 +1、方便计算,gap 每次除以 3,每组数据个数为 n/gap。
第一趟 gap=n/3,每组 3 个数据,最坏消耗 (1+2) × (n/3);
第二趟 gap=n/9,每组 9 个数据,最坏消耗 (1+2+…+8) × (n/9) ≈ 4n;
……
最后一趟 gap==1,已经接近有序,就是普通插入排序,消耗约 n。
一趟一趟加总起来,量级就是 O(N^1.3) 啦。
选择排序:一次挑出最大和最小
升级版选择排序一轮挑两个:从两头向中间收拢,同时选出最小的放左边、最大的放右边。
void SelectSort(int* a, int n)
{
    int begin = 0, end = n - 1;
    while (begin < end)
    {
        int mini = begin, maxi = begin;
        for (int i = begin + 1; i <= end; i++)
        {
            if (a[i] < a[mini]) mini = i;
            if (a[i] > a[maxi]) maxi = i;
        }
        Swap(&a[begin], &a[mini]);
        if (begin == maxi)      // 小坑:最大值刚被换走了
            maxi = mini;
        Swap(&a[end], &a[maxi]);
        begin++;
        end--;
    }
}
那个
begin == maxi的小补丁很关键:最小值和左端交换时,可能恰好把最大值挪到了 mini 的位置,不修一下 maxi 就指错了人。
冒泡排序:相邻的悄悄交换
void BubbleSort(int* a, int n)
{
    for (int i = 0; i < n - 1; i++)
    {
        int flag = 0;
        for (int j = 0; j < n - 1 - i; j++)
        {
            if (a[j] > a[j + 1])
            {
                Swap(&a[j], &a[j + 1]);
                flag = 1;
            }
        }
        if (flag == 0)   // 一整圈没人交换,说明已经有序
            break;
    }
}
加个 flag 小旗子,数组本来就有序时可以提前收工。不过冒泡更多是教学意义,实战里轮不太到它。
堆排序:先把山堆起来
还记得堆吗?它来干活了。升序就建大堆:堆顶是最大值,把它和末尾交换,规模减一后向下调整,最大值一个个沉到队尾。这里先认识堆排序离不开的两个小动作:
// 向上调整(小堆:父亲大了就往上换,把小的托上去)
void HeapAdjustUp(int* a, int child)
{
    int parent = (child - 1) / 2;
    while (child > 0)            // 爬到顶就停
    {
        if (a[parent] > a[child])
        {
            Swap(&a[parent], &a[child]);
            child = parent;
            parent = (child - 1) / 2;
        }
        else
            break;
    }
}

// 向下调整(大堆:孩子大了就往下换,假设法挑左右)
void HeapAdjustDown(int* a, int n, int parent)
{
    int child = parent * 2 + 1;       // 先假设左孩子
    while (child < n)
    {
        if (child + 1 < n && a[child + 1] > a[child])
            child++;                  // 右孩子更大,就换成它
        if (a[child] > a[parent])
        {
            Swap(&a[parent], &a[child]);
            parent = child;
            child = parent * 2 + 1;
        }
        else
            break;
    }
}建堆也有两种口味:向上调整建堆是把元素一个个插到末尾往上爬,每个都要走 O(logN),整体 O(N·logN);向下调整建堆从最后一个父亲开始往前调,最后一层节点最多却只需一步,摊下来整体是 O(N)——更划算。下面用的就是向下调整建堆:
void HeapSort(int* a, int n)
{
    for (int i = (n - 1 - 1) / 2; i >= 0; i--)  // 从最后一个父亲建堆
        HeapAdjustDown(a, n, i);

    int end = n - 1;
    while (end > 0)
    {
        Swap(&a[0], &a[end]);        // 堆顶(最大)放到末尾
        HeapAdjustDown(a, end, 0);   // 剩下的重新调整
        end--;
    }
}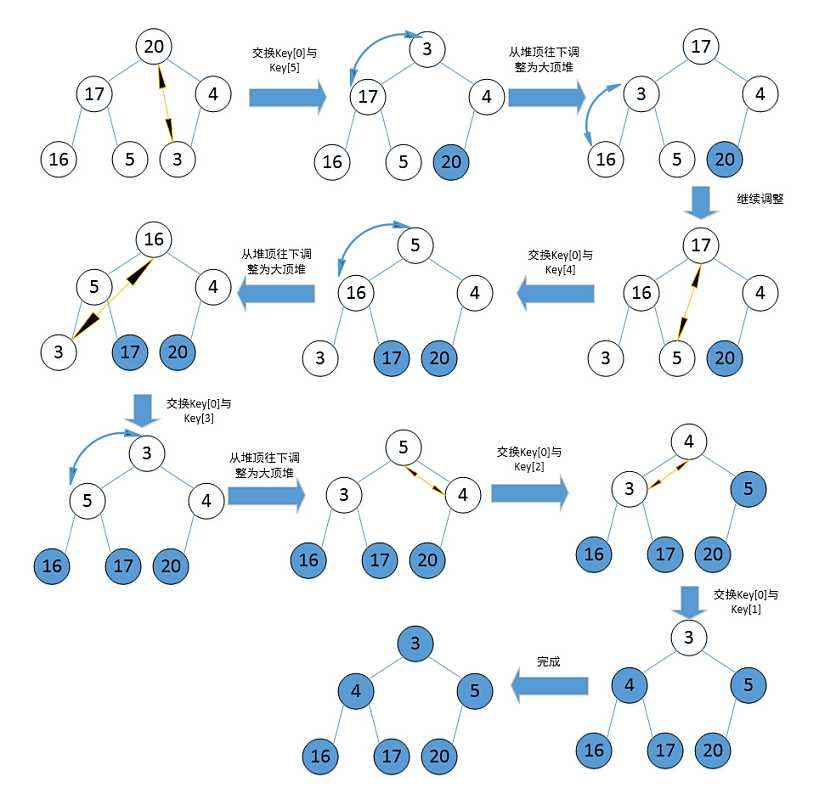
建堆 O(N),每次调整 O(logN),整体 O(N*logN),而且不需要额外空间。
快速排序:选定基准分两边
快排的思路是递归的(有没有想起二叉树):单趟让一个数(key)落到它最终的位置,顺便把区间劈成「左边都比它小、右边都比它大」,再对左右区间重复。
// hoare 版本的单趟
int PartSort1(int* a, int left, int right)
{
    int keyi = left;
    int begin = left, end = right;
    while (begin < end)
    {
        while (begin < end && a[end] >= a[keyi])
            end--;                    // 右边先走,找小
        while (begin < end && a[begin] <= a[keyi])
            begin++;                  // 左边找大
        Swap(&a[begin], &a[end]);
    }
    Swap(&a[begin], &a[keyi]);        // 相遇处与key交换
    return begin;                     // key 的最终位置
}
为什么让 key 在左边时右边先走?因为 R 停下的条件是「遇到比 key 小的值」,这样最终相遇的位置一定比 key 小,换到左边正合适。
快排有两个软肋和补救:数组有序时会退化成 O(N²) 且递归太深栈溢出——用「三数取中」选 key(左、中、右三个里取中间值)化解;递归到最后一层占了总量一半,有点浪费——小区间(少于 10 个数)直接改用插入排序。
把两位补救请进代码里——三数取中负责选 key,小区间优化负责省递归:
// 三数取中:左、中、右三个里选出中间值
int GetMidi(int* a, int left, int right)
{
    int midi = left + (right - left) / 2;
    if (a[left] < a[midi])
    {
        if (a[midi] < a[right])
            return midi;
        else if (a[left] < a[right])
            return right;
        else
            return left;
    }
    else   // a[left] > a[midi]
    {
        if (a[midi] > a[right])
            return midi;
        else if (a[left] < a[right])
            return left;
        else
            return right;
    }
}

void QuickSort(int* a, int left, int right)
{
    if (left >= right)     // 只剩一个值或区间不存在,递归到头
        return;

    if (right - left + 1 < 10)    // 小区间优化:
    {
        InsertSort(a + left, right - left + 1);   // 少于10个直接插入排序
    }
    else
    {
        int keyi = PartSort1(a, left, right);
        // [left, keyi-1] keyi [keyi+1, right]
        QuickSort(a, left, keyi - 1);      // O(logN) 层的递归
        QuickSort(a, keyi + 1, right);
    }
}
除了 hoare,单趟还有挖坑法——先把 key 挖出来当成一个坑,左右轮流过去填,最后相遇的位置就是坑,不用再费心分析相遇位置的问题:
还有前后指针法,用 prev、cur 两根指针,cur 在前探路,把比 key 小的值一个个接到 prev 身后:
int PartSort3(int* a, int left, int right)   // 前后指针
{
    int keyi = left;
    int prev = left, cur = left + 1;
    while (cur <= right)
    {
        if (a[cur] < a[keyi] && ++prev != cur)
            Swap(&a[prev], &a[cur]);   // 小的往前挪
        cur++;
    }
    Swap(&a[keyi], &a[prev]);
    return prev;
}担心递归太深的话,还能用栈或队列把待排序的区间存起来迭代处理——前面亲手写过的栈和队列,在这里派上了用场。为让非递归版自成一体,排序文件里照搬了这么一套栈和队列:
// 栈(和「栈和队列」那一章同款)
typedef int STDataType;
typedef struct Stack
{
    STDataType* a;   // 动态数组存储栈中元素
    int top;         // 栈顶指针,指向栈顶元素的位置
    int capacity;    // 容量
}ST;

void StackInit(ST* ps)
{
    assert(ps);
    ps->a = (STDataType*)malloc(sizeof(STDataType) * 4);
    if (ps->a == NULL)
    {
        perror("malloc fail");
        exit(1);
    }
    ps->top = -1;      // top 指向栈顶元素,所以初始化为 -1
    ps->capacity = 4;
}

void StackDestroy(ST* ps)
{
    assert(ps);
    free(ps->a);
    ps->a = NULL;
    ps->top = 0;
    ps->capacity = 0;
}

void StackPush(ST* ps, STDataType x)
{
    assert(ps);
    if (ps->top == ps->capacity - 1)   // 栈满,扩容
    {
        int newCapacity = (ps->capacity == 0) ? 4 : ps->capacity * 2;
        STDataType* tmp = (STDataType*)realloc(ps->a,
                            sizeof(STDataType) * ps->capacity * 2);
        if (tmp == NULL)
        {
            perror("realloc fail");
            exit(1);
        }
        ps->a = tmp;
        ps->capacity = newCapacity;
    }
    ps->top++;
    ps->a[ps->top] = x;
}

void StackPop(ST* ps)
{
    assert(ps);
    assert(ps->top != -1);   // 栈不为空
    ps->top--;
}

STDataType StackTop(ST* ps)
{
    assert(ps);
    assert(ps->top != -1);
    return ps->a[ps->top];
}

bool StackEmpty(ST* ps)
{
    assert(ps);
    return ps->top == -1;
}
// 队列(同款照搬)
typedef int QDDataType;
typedef struct QueueNode
{
QDDataType data;
struct QueueNode* next;
}QNode;
typedef struct Queue
{
QNode* front; // 队头
QNode* back; // 队尾
int size; // 元素个数
}Queue;
void QueueInit(Queue* pq)
{
assert(pq);
pq->front = NULL;
pq->back = NULL;
pq->size = 0;
}
void QueueDestroy(Queue* pq)
{
assert(pq);
QNode* cur = pq->front;
while (cur)
{
QNode* tmp = cur;
cur = cur->next;
free(tmp);
}
pq->front = NULL;
pq->back = NULL;
pq->size = 0;
}
void QueuePush(Queue* pq, QDDataType x)
{
assert(pq);
QNode* newNode = (QNode*)malloc(sizeof(QNode));
if (newNode == NULL)
{
perror("malloc fail");
exit(1);
}
newNode->next = NULL;
newNode->data = x;
if (pq->back == NULL) // 空队列
pq->front = pq->back = newNode;
else
{
pq->back->next = newNode;
pq->back = newNode;
}
pq->size++;
}
void QueuePop(Queue* pq)
{
assert(pq);
assert(pq->size != 0);
if (pq->front->next == NULL) // 只剩一个节点
{
free(pq->front);
pq->front = pq->back = NULL;
}
else
{
QNode* tmp = pq->front;
pq->front = pq->front->next;
free(tmp);
}
pq->size--;
}
QDDataType QueueFront(Queue* pq)
{
assert(pq);
assert(pq->size != 0);
return pq->front->data;
}
bool QueueEmpty(Queue* pq)
{
assert(pq);
return pq->size == 0;
}// 栈的写法:把待排序的区间存进栈里
void QuickSortNonRStack(int* a, int left, int right)
{
ST st;
StackInit(&st);
StackPush(&st, right); // 先右后左入栈
StackPush(&st, left);
while (!StackEmpty(&st))
{
int begin = StackTop(&st); StackPop(&st);
int end = StackTop(&st); StackPop(&st);
int keyi = PartSort3(a, begin, end);
// [begin, keyi-1] keyi [keyi+1, end]
if (keyi + 1 < end) // 先入右区间
{
StackPush(&st, end);
StackPush(&st, keyi + 1);
}
if (begin < keyi - 1) // 再入左区间
{ // 栈是先进后出,这样左区间先出、先排
StackPush(&st, keyi - 1);
StackPush(&st, begin);
}
}
StackDestroy(&st);
}换成队列也一模一样,只是先进先出,所以左右区间入队的顺序和栈相反——先入左区间:
void QuickSortNonRQueue(int* a, int left, int right)
{
    Queue q;
    QueueInit(&q);
    QueuePush(&q, left);       // 先左后右入队
    QueuePush(&q, right);

    while (!QueueEmpty(&q))
    {
        int begin = QueueFront(&q); QueuePop(&q);
        int end = QueueFront(&q);   QueuePop(&q);

        int keyi = PartSort1(a, begin, end);
        // [begin, keyi-1] keyi [keyi+1, end]
        if (begin < keyi - 1)        // 先入左区间
        {
            QueuePush(&q, begin);
            QueuePush(&q, keyi - 1);
        }
        if (keyi + 1 < end)          // 再入右区间
        {
            QueuePush(&q, keyi + 1);
            QueuePush(&q, end);
        }
    }
    QueueDestroy(&q);
}
归并排序:把两半温柔地合起来
归并是标准的分治:一直对半拆到只剩一个数,然后把两个有序的小数组归并成一个大有序数组,借一个临时数组中转,最后拷回来。
void _MergeSort(int* a, int* tmp, int begin, int end)
{
    if (begin >= end)
        return;
    int mid = (begin + end) / 2;
    _MergeSort(a, tmp, begin, mid);      // 左半排好
    _MergeSort(a, tmp, mid + 1, end);    // 右半排好

    int begin1 = begin, end1 = mid;
    int begin2 = mid + 1, end2 = end;
    int i = begin;
    while (begin1 <= end1 && begin2 <= end2)
    {
        if (a[begin1] <= a[begin2])      // 相等取左边,稳定的小秘诀
            tmp[i++] = a[begin1++];
        else
            tmp[i++] = a[begin2++];
    }
    while (begin1 <= end1) tmp[i++] = a[begin1++];
    while (begin2 <= end2) tmp[i++] = a[begin2++];

    memcpy(a + begin, tmp + begin, (end - begin + 1) * sizeof(int));
}
分割区间时一定要用
[begin, mid][mid + 1, end]。如果写成[begin, mid-1][mid, end],当区间是「偶数、偶数+1」这样相邻的两个数时,mid 会退回那个偶数,右区间还是原来的区间,就死循环了。
补上外面借临时数组的外壳,归并就算完整了:
void MergeSort(int* a, int n)
{
    int* tmp = (int*)malloc(sizeof(int) * n);
    if (tmp == NULL)
    {
        perror("malloc");
        return;
    }
    _MergeSort(a, tmp, 0, n - 1);
    free(tmp);
}
迭代版的归并靠 gap 从 1 开始成倍长大,每轮把相邻两组有序区间归并。要小心 n 不是 2 的整数幂时区间越界的小尾巴:
void MergeSortNonR(int* a, int n)
{
    int* tmp = (int*)malloc(sizeof(int) * n);
    if (tmp == NULL)
    {
        perror("malloc");
        return;
    }

    int gap = 1;    // gap:每组归并的数据个数
    while (gap < n)
    {
        for (int i = 0; i < n; i += 2 * gap)
        {
            int begin1 = i, end1 = i + gap - 1;
            int begin2 = i + gap, end2 = i + 2 * gap - 1;
            // n 不是 2*gap 的整数倍时,end1/begin2/end2 都可能越界
            if (begin2 >= n)        // 右区间整个越界,这组不用归并
                break;
            if (end2 >= n)          // 只是 end2 越界,修正一下再归并
                end2 = n - 1;

            int j = i;
            while (begin1 <= end1 && begin2 <= end2)
            {
                if (a[begin1] <= a[begin2])
                    tmp[j++] = a[begin1++];
                else
                    tmp[j++] = a[begin2++];
            }
            while (begin1 <= end1) tmp[j++] = a[begin1++];
            while (begin2 <= end2) tmp[j++] = a[begin2++];

            memcpy(a + i, tmp + i, (end2 - i + 1) * sizeof(int));
            // 一组一组拷回去;整块拷会覆盖掉还没归并的数据
        }
        gap *= 2;
    }
    free(tmp);
}
计数排序:不比较也能排队
它根本不比大小,而是数每个数出现了几次,再按数组的自然顺序把它们倒回原数组。用 count[a[i] - min] 做相对映射,数据范围集中时特别省空间。时间 O(N + range),只适合整数。
void CountSort(int* a, int n)
{
    int min = a[0], max = a[0];
    for (int i = 1; i < n; i++)
    {
        if (a[i] < min) min = a[i];
        if (a[i] > max) max = a[i];
    }
    int range = max - min + 1;
    int* count = (int*)calloc(range, sizeof(int));   // 相对映射
    if (count == NULL)
    {
        perror("malloc");
        return;
    }

    for (int i = 0; i < n; i++)       // 统计每个数出现几次
        count[a[i] - min]++;

    int j = 0;
    for (int i = 0; i < range; i++)   // 按自然顺序倒回原数组
        while (count[i]--)
            a[j++] = i + min;

    free(count);
}
一张表记住它们
| 算法 | 时间复杂度 | 空间 | 稳定性 |
|---|---|---|---|
| 直接插入 | O(N²) | O(1) | 稳定 |
| 希尔 | O(N^1.3) | O(1) | 不稳定 |
| 选择 | O(N²) | O(1) | 不稳定 |
| 堆排序 | O(N*logN) | O(1) | 不稳定 |
| 冒泡 | O(N²) | O(1) | 稳定 |
| 快速排序 | O(N*logN) | O(logN) 递归 | 不稳定 |
| 归并 | O(N*logN) | O(N) | 稳定 |
为什么稳、为什么不稳,源码里都写了理由:
· 直接插入——遇到相等的数就停下,相对顺序不变,稳定;
· 希尔——相同的数据分到同一组就像插入(稳),分到不同组就无法控制,不稳定;
· 选择——遍历选出最小值放到最左边,像 [2,2,1,1] 这样的数组,1 交换可控、2 交换后顺序就乱了,不稳定;
· 堆排序——堆顶和堆底一交换顺序就乱,不稳定;
· 冒泡——相等就不交换,稳定;
· 快速排序——最左边的元素跟中间一换就乱,不稳定;
· 归并——取小的尾插,且判断用 <= 保证相等时取左边,稳定。
实践中常被点名的是快排和堆排序;插入排序虽慢却常被拿来做小区间优化的搭档;冒泡同学主要负责让我们理解「交换」这件事本身。
想亲眼看看谁快谁慢?源码里配了一个性能对比的小台子——同一份乱序数据复制成八份,让每个算法各跑一遍、用 clock() 计时:
void TestOP()
{
    srand((unsigned int)time(NULL));
    const int N = 10000000;                        // 一千万个数
    int* a1 = (int*)malloc(sizeof(int) * N);
    int* a2 = (int*)malloc(sizeof(int) * N);
    int* a3 = (int*)malloc(sizeof(int) * N);
    int* a4 = (int*)malloc(sizeof(int) * N);
    int* a5 = (int*)malloc(sizeof(int) * N);
    int* a6 = (int*)malloc(sizeof(int) * N);
    int* a7 = (int*)malloc(sizeof(int) * N);
    int* a8 = (int*)malloc(sizeof(int) * N);
    for (int i = 0; i < N; i++)
    {
        a1[i] = rand() + i;   // +i 让重复少一点(rand 本身只有三万多不重复)
        a2[i] = a1[i];
        a3[i] = a1[i];
        a4[i] = a1[i];
        a5[i] = a1[i];
        a6[i] = a1[i];
        a7[i] = a1[i];
        a8[i] = a1[i];
    }

    int begin1 = clock();
    //InsertSort(a1, N);      // O(N²),太慢,一般不放开
    int end1 = clock();

    int begin2 = clock();
    //ShellSort(a2, N);
    int end2 = clock();

    int begin3 = clock();
    //SelectSort(a3, N);      // O(N²),太慢
    int end3 = clock();

    int begin4 = clock();
    HeapSort(a4, N);
    int end4 = clock();

    int begin5 = clock();
    QuickSort(a5, 0, N - 1);
    int end5 = clock();

    int begin6 = clock();
    MergeSort(a6, N);
    int end6 = clock();

    int begin7 = clock();
    //BubbleSort(a7, N);      // 只有教学意义,太慢
    int end7 = clock();

    int begin8 = clock();
    CountSort(a8, N);
    int end8 = clock();

    printf("InsertSort:%d ms\n", end1 - begin1);
    printf("ShellSort:%d ms\n", end2 - begin2);
    printf("SelectSort:%d ms\n", end3 - begin3);
    printf("HeapSort:%d ms\n", end4 - begin4);
    printf("QuickSort:%d ms\n", end5 - begin5);
    printf("MergeSort:%d ms\n", end6 - begin6);
    printf("BubbleSort:%d ms\n", end7 - begin7);
    printf("CountSort:%d ms\n", end8 - begin8);

    free(a1); free(a2); free(a3); free(a4);
    free(a5); free(a6); free(a7); free(a8);
}
真跑一次你会看到:冒泡、选择、插入这些 O(N²) 的,一千万个数要等好久;堆排、快排、归并、计数这些 O(N·logN) 或更低的,眨眼就完事——这就是复杂度的分量。
一个课本外的追问:有 10 亿个整数要排成有序,但内存只有 1G 装不下,怎么办?
思路是外部排序:10 亿个 int 约 4G,就依次读入大文件、每读 1G 排好(快排等)写成一个有序小文件,得到 4 个有序小文件,再把它们归并起来。归并在这种大数据场景里派上了大用场。
顺手的小知识点:C++ 里自带快排,一行就够——
#include <algorithm>
std::sort(a, a + 10); // 升序
std::sort(a, a + 10, std::greater<int>()); // 降序
✿ 摘要
- 插入像理牌;希尔 = 预排序 + 插入,gap 按
gap/3+1缩小。 - 选择排序双向挑最大最小,小心
maxi被换走的小坑。 - 堆排序升序建大堆:交换堆顶 → 向下调整 → 尾部缩小。
- 快排三要素:三数取中防退化、小区间插入省递归、挖坑/前后指针换口味。
- 归并稳定但需 O(N) 辅助;计数排序相对映射,O(N + range)。
愿当下的花如你所见般美丽
评论交流
欢迎留下你的想法