一个 int 变量,放在内存里到底长什么样?为什么同一个二进制串,换个「观看角度」就变成了完全不同的数字?
内存不像我们想的那样平淡——每一个数据都有自己专属的「小房间」,而且房间里还藏着大小端、补码、整型提升这些有趣的小规则。今天,我们推开这扇门看一看。
先看一眼内存的地图
程序跑起来之后,内存会被划分成好几块区域,各有各的分工:
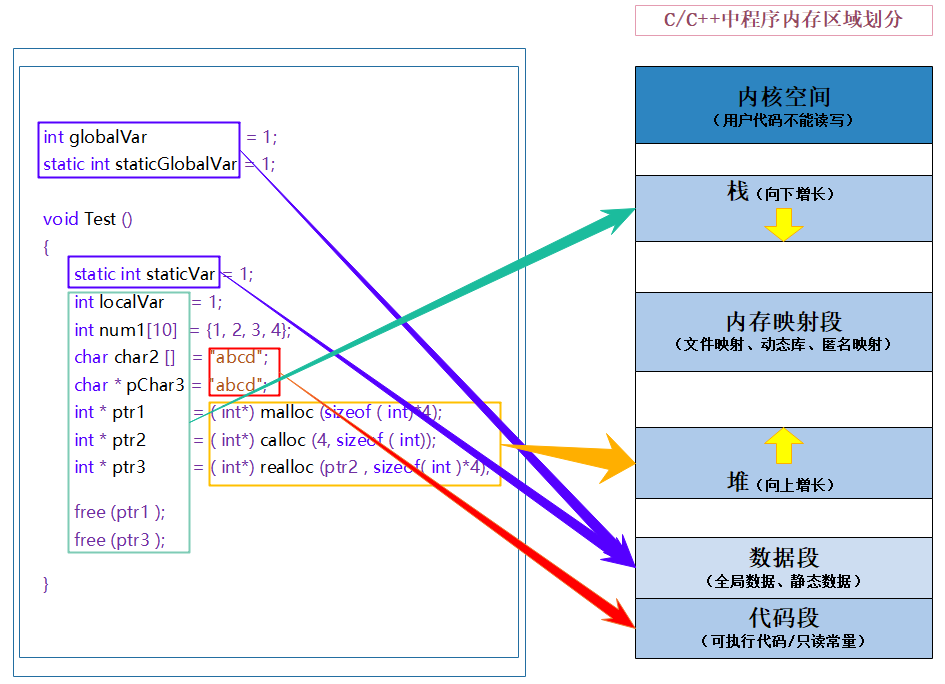
而放眼整个计算机,从快到慢、从小到大,还有一条经典的存储金字塔:寄存器 → 高速缓存 → 主存 → 磁盘 → 网络存储。越往上越快越小,越往下越慢越大。数据到底住哪一层,取决于它被用得有多频繁。
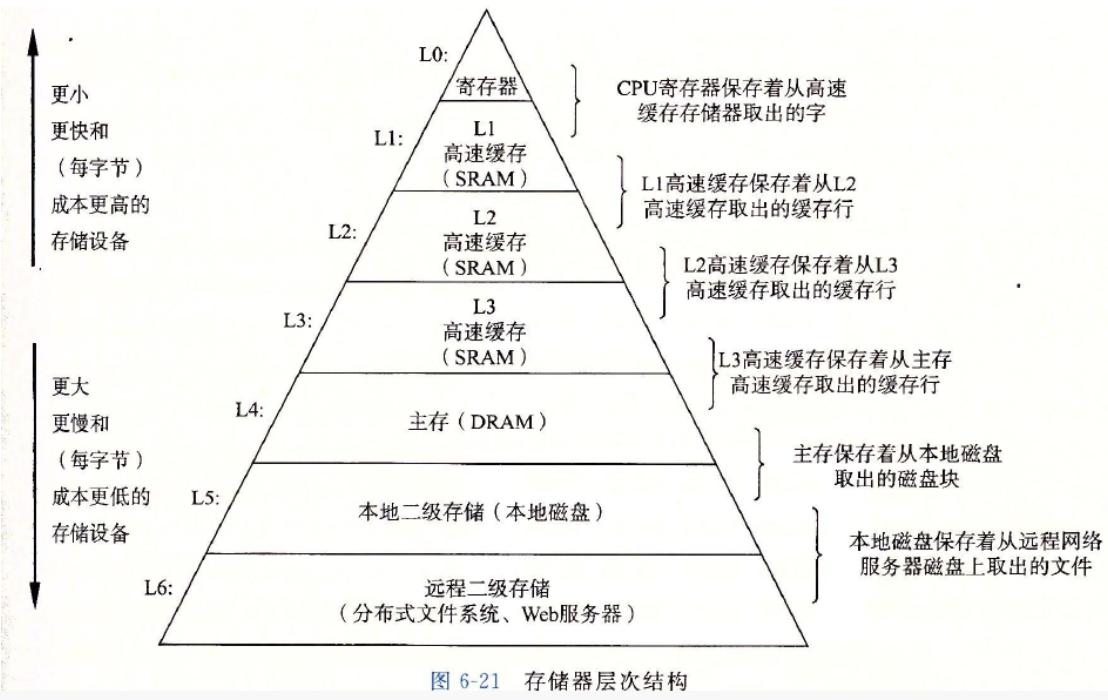
整数在内存里怎么"躺"着
整数在内存里用补码表示。对于有符号数,一套「原码 → 反码 → 补码」的换算规则牢牢记在心上:
正数:原、反、补都相同。
负数:原码符号位为 1,反码把数值位按位取反,补码 = 反码 + 1。
比如 char a = -1;,它最终存的是 11111111。
大小端:同一个数字,两种"睡姿"
拿 0x11223344 来说,内存从低地址到高地址,有两种摆放方式:
大端字节序:11 22 33 44   →  高位字节存低地址
小端字节序:44 33 22 11   →  低位字节存低地址
可以用一个小函数判断当前机器是大端还是小端:
int check_sys() {
    int a = 1;
    return (*(char*)&a);   // 返回 1 是小端,返回 0 是大端
}
VS2022 就是典型的小端模式。
整型提升:小类型上楼梯
当 char、short 这种「小类型」参加运算时,会被提升到 int。提升时,有符号数补符号位,无符号数补 0:
char a = -1;         // 存的是 11111111
// 有符号 char 提升:符号位 1 → 高位全补 1
// 变成 11111111 11111111 11111111 11111111
// %d 打印时要取反加一还原成 -1

unsigned char b = -1; // 存的是 11111111
// 无符号 char 提升:高位全补 0
// 变成 00000000 00000000 00000000 11111111 = 255
记住这个「上楼梯」规则,很多看似诡异的输出就豁然开朗了。
两个有趣的"陷阱题"
// ① 指针只挪一个字节会怎样?
int a[4] = {1, 2, 3, 4};          // 01 00 00 00 02 ...
int* p2 = (int*)((int)a + 1);     // 只跳过 1 个字节!
// *p2 在小端机器上会读出 0x02000000

// ② 永远停不下来的循环
unsigned char i = 0;              // 范围 0~255
for (i = 0; i <= 255; i++)        // 到 255 后加 1 又变回 0
    printf("hello world\n");      // 循环永不结束!
✿ 摘要
- 内存分为栈、堆、数据段、代码段等区域,各有分工。
- 整数以补码存储;负数按「原码→反码→补码」换算。
- 大端高位存低地址,小端低位存低地址;VS 是小端。
- 整型提升:小类型参与运算时提升到 int,有符号补符号位、无符号补 0。
- 理解存储规则,才能看懂大小端、指针偏移、死循环这类经典题。
愿当下的花如你所见般美丽
评论交流
欢迎留下你的想法